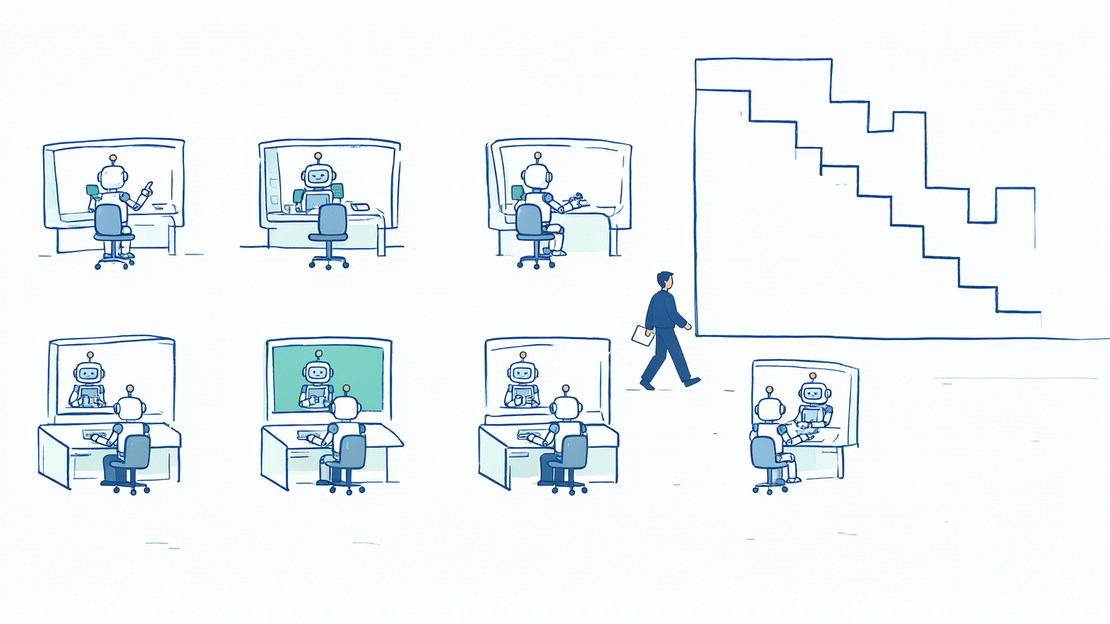
Когда обсуждают ИИ в поддержке, разговор почти всегда скатывается к выбору модели: какая умнее, какая дешевле за запрос. Мы через это прошли и пришли к неудобному выводу: модели — не самая дорогая часть агентной поддержки. Самая дорогая часть — повторы.
Речь про вторую линию. Не «где находится кнопка», а обращения, где нужно открыть код, разобраться в логах, докопаться до причины и предложить правку. Именно там агент делает больше всего шагов — и именно там проще всего сжечь бюджет впустую. Один и тот же агент перечитывает файл за файлом, прежде чем находит нужную строку; каждый такой проход — оплаченный вызов. Умножьте это на поток обращений, и становится видно, куда на самом деле уходят деньги.
Мы перестроили пул так, чтобы дешёвые модели закрывали основную массу обращений, а дорогие подключались только тогда, когда дело реально дошло до сложной причины. Ниже — как устроена эта лестница, что она даёт и где честно не работает.
Table Of Contents
Как это выглядело до: вторая линия целиком на людях
Вторая линия — это то, что не закрывается ссылкой на инструкцию. Клиент пишет, что при выгрузке отчёта сумма показывается дважды, или что интеграция перестала передавать контрагентов после обновления. Чтобы ответить, инженер открывает проект, поднимает логи, воспроизводит, находит строку, правит, проверяет, оформляет правку.
Самое дорогое в этой цепочке — не сервера и не подписки, а внимание человека, который умеет так разбираться. Оно к тому же плохо масштабируется: очередь растёт, пока кто-то свободен, и стоит на месте, когда свободных нет. «Разберёмся к концу недели» стоит репутации, а «разобрались сегодня» стоит чьего-то рабочего вечера.
Первая версия автоматизации была наивной: поставить рядом самую сильную модель из доступных и отдавать ей всё подряд. Через некоторое время стало видно, что платим мы не за умные ответы, а за перечитывание, перепроверку и переспрашивание. Сильная модель одинаково старательно открывает README и в сложном инциденте, и в обращении, где ответ лежит на поверхности. После этого стало ясно, что агентная поддержка — это не про выбор модели, а про устройство очереди.
Как устроен пул: восемь полос и одна очередь
Сейчас это восемь воркеров — мы называем их полосами. У каждой полосы своя очередь инструментов, своё состояние, своя жизнь. Обращения приходят в общую очередь задач, а полоса забирает оттуда следующую работу, когда освобождается. Никто не «назначает» задачу конкретному агенту вручную: диспетчеризация сводится к тому, что первый свободный берёт первый подходящий.
Такое устройство снимает два ограничения сразу. Свободная полоса не ждёт, пока коллега закончит со своим обращением, а сложное обращение не блокирует очередь для простых. Восемь параллельных дорожек вместо одной очереди к живому инженеру — это, по сути, тот же дефицит внимания, решённый в другую сторону: люди у нас теперь в конце цепочки, а не в середине.
Как собрать сам пул и что происходит внутри полосы, мы разбирали в статье про пул AI-агентов, а отдельный материал — про то, как эти агенты живут в контейнерах и почему без изоляции на полосу так делать нельзя. Здесь нас интересует только экономика.
И третья составляющая — телеметрия v2. Каждый шаг агента пишется: что вызывал, сколько раз, сколько это стоило, сколько времени прошло до готовой правки. Без этого разговора про деньги не получилось бы: нельзя управлять тем, что не измеряется поштучно.
Лестница моделей: тиры 0 / 60 / 120 / 240
Дальше — то, ради чего всё затевалось. У полосы есть тир: 0, 60, 120 или 240. Это пороги по числу шагов задачи. Задача всегда стартует в нулевом тире, на самой дешёвой модели из набора. Если она не закрылась, пока не перешагнула порог, она повышается в тире — и получает модель сильнее.
Ключевая идея: эскалация по числу шагов — дешёвый способ отличить простую задачу от сложной. Не нужен отдельный «классификатор сложности», который сам стоит вызова и сам ошибается. Простое обращение закрывается за несколько шагов и не доживает до верхних тиров: если агент ковыряется долго, значит задача действительно не типовая, и её пора вести наверх.
Набор моделей в пуле выстроен по той же логике — от дешёвых облачных до локальных на своём железе и платного резерва на самом верху. Дешёвое звено работает на потоке, локальное — там, где не хочется платить за каждый запрос в облаке, а платный резерв прибережён для случаев, где цена ошибки выше, чем цена вызова.
Тир, порог, работа: как распределяется нагрузка
| Тир | Когда включается | Что делает |
|---|---|---|
| 0 | старт любой задачи, пока она укладывается в базовый бюджет шагов | дешёвое звено: разбирает обращение, ищет типовую причину, готовит черновик ответа |
| 60 | задача перешагнула 60 шагов и не закрылась | шаг наверх по лестнице: чтение кода и логов, попытка локализовать причину |
| 120 | локализация не получилась, агент ходит по кругу | подключаются локальные модели на нашем железе, где стоимость шага другая |
| 240 | верхний порог, самые упрямые обращения | платный резерв: дорогая модель включается только сюда и только по факту |
Порядок звеньев важнее конкретных имён моделей: состав лестницы мы поправляем часто, сама конструкция с тех пор не менялась. И обращу внимание на то, чего в таблице нет: ни одна ступенька не «решает сама». Всё, что делает агент, заканчивается черновиком ответа или pull request — а мержит человек. Автоматизирован разбор, а не ответственность.
Что это даёт деньгам
Первое и главное: дорогие вызовы уходят только на сложное. Основная масса обращений — повторющиеся, с типовой причиной — закрывается внизу лестницы, и в разборе про восемь агентов на GPU видно, как это распределяется по полосам. Мы строили пул ровно под этот профиль: дешёвые модели закрывают 80% обращений, а остальное — то, за что не жалко платить сверху.
Второе: квота перестала быть аварийным сценарием. У любой подписки на модели есть потолок, и раньше её исчерпание выглядело как падение: полоса продолжает дёргаться, получает отказ, повторяет. Сейчас, когда квота исчерпана, воркер штатно выключается — уходит в enabled=false, а пул продолжает работать на остальных полосах. Никто не ретраится об закрытую дверь и не сжигает на этом время очереди.
Info
Штатное отключение — это не про отказоустойчивость, а про экономику. Пока полоса бьётся об исчерпанную квоту, задачи в очереди копятся, а после включения все эти «бесплатные» попытки всё равно придётся переработать. Выключить заранее дешевле, чем починить потом.
Третье: монитор подписок. Он смотрит остатки по подключениям и отключает полосу заранее, до того как упрёмся в ноль посреди рабочего дня. Восемь полос при этом не обязаны быть живыми одновременно: пул, где одна дорожка временно спит, — это штатное состояние, а не поломка.
Телеметрия: что считаем и как это меняет поведение
Считаем пять вещей: число шагов на задачу, вызовы инструментов, повторы (один и тот же файл или запрос дважды на одной задаче), время до готового патча и стоимость вызова. Первые три — про поведение, последние два — про деньги. Сводить их по отдельности бессмысленно: дешёвая задача, которую агент мурыжил полночи, не такая уж дешёвая, а дорогая правка, сделанная за три шага, как правило, стоит дешевле человеческой.
Warning
Главный вывод телеметрии звучит контринтуитивно: агент, который «думает» дольше одного шага, дешевле агента, который «пробует всё». Каждый повторный вызов тянет за собой весь контекст задачи, и цена растёт не на один шаг, а на всё перечитанное заново. Поэтому правки в промпты мы делаем по числу повторов, а не по среднему времени ответа.
Повторы — самая говорящая метрика. Если полоса на одной задаче перечитывает один и тот же файл несколько раз, это почти никогда не «сложная причина»: это инструмент показал не то, или контекст не влез, или инструкция толкает агента в перебор. Телеметрия v2 как раз и нужна, чтобы отличать «задача была трудная» от «агент топтался на месте»: вторая формулировка всегда означает конкретную правку в пуле, а не «ну, бывает».
Где человек быстрее и зачем он в цепочке
Честно про ограничения. Агент не заменяет инженера там, где причину нужно сначала узнать из головы, а не из кода: «эта интеграция работает иначе у трёх клиентов, мы договаривались устно». Там, где решение — согласование, а не правка, он тоже бесполезен: можно написать идеальный черновик, но отвечать за него не ему.
Есть и более прозаичные случаи, где человек выигрывает. Если инженер уже знает, где проблема, — он дойдёт быстрее, чем агент дойдёт до того места. Если обращение требует доступа к прод-данным, к чужому стенду, к тому, что специально не отдаётся воркеру. Если правка касается того, где агент никогда не работал: нужны суждения об архитектуре, а не поиск строки.
Поэтому человек стоит в конце, а не в начале: он читает черновик или pull request и решает, годится ли. Это не «подстраховка на всякий случай», а разделение труда: дешёвая работа — разбор, дорогая — решение.
Итог
- Повторы, а не токены, — главная статья расходов в агентной второй линии. Пока их не видно поштучно, любая оптимизация «выгоднее модель» работает в пользу иллюзии.
- Лестница тиров 0 / 60 / 120 / 240 превращает число шагов в переключатель стоимости: простое остаётся внизу, упрямое поднимается наверх. Дешёвые модели закрывают 80% обращений — именно ради этого всё затевалось.
- Квота перестала быть падением: исчерпание выключает полосу штатно, монитор подписок делает это заранее, пул продолжает работать.
- Всё, что делает агент, — черновик ответа или pull request. Мержит человек, и это единственное, что мы не собираемся автоматизировать.
- Телеметрия по шагам, повторам и стоимости — не отчётливость, а рабочий инструмент: она говорит, где править инструкции и инструменты, а где менять модель в лестнице.
Если у вас вторая линия поддержки — это очередь к одним и тем же занятым людям, начните не с выбора модели, а с очереди, параллельных полос и подсчёта повторов. Посмотреть, как мы это делаем целиком, можно в разделе ИИ-услуг.